09.10.2026 Lukas Lötters
Unternehmensdaten eigenständig abfragen, analysieren und verständlich interpretieren: Data Agents sollen die geschäftliche Datennutzung einfacher und effektiver gestalten. Dabei soll es möglich sein, in natürlicher Sprache mit den Daten zu interagieren und komplexe Auswertungen ohne Programmier- oder SQL-Kenntnisse durchzuführen.
In der Praxis zeigt sich jedoch, dass die intelligenten Assistenten mehr als ein leistungsfähiges KI-Modell und die Verbindung zu einer Data & AI Plattform benötigen, um valide Ergebnisse zu liefern. Entscheidend ist, ob der Agent die Daten richtig einordnen kann. Diesen sogenannten Kontext bereitzustellen, bedeutet Arbeit – unabhängig vom gewählten Werkzeug.
Zwischen Erwartung und Projektalltag
Bei meiner Tätigkeit in Kundenprojekten begegnet mir immer wieder eine prinzipiell nachvollziehbare Anforderung: Der neue Agent soll möglichst umgehend Fragen zum Unternehmen und Geschäft beantworten. Schließlich wird vom Einsatz Künstlicher Intelligenz erwartet, dass er Dinge vereinfacht und nicht zusätzlichen Aufwand verursacht.
Genau hier liegt der Knackpunkt. Ein Data Agent muss nicht nur wissen, welche Tabellen vorhanden sind. Er braucht auch Informationen zu Kennzahlen, Berechnungsregeln und internen Begriffen. Kurz gesagt: Er muss das jeweilige Business und seine Rahmenbedingungen kennen. Dieses Wissen gilt es, für ihn zu erschließen. Die Vorstellung, dass er das alles von Anfang an mitbringt, hält der Praxis nicht stand.
Deshalb greift für mich eine Diskussion zu kurz, die sich ausschließlich um die Auswahl des passenden Tools dreht. Jedes Werkzeuge – wie etwa Databricks Genie, Fabric Data Agent oder Excel Add-ins – hat seine individuellen Grenzen. Doch die grundlegende Aufgabe bleibt dieselbe: Wir müssen dem Agenten den notwendigen Kontext vermitteln, also wie das Geschäft des betreffenden Unternehmens funktioniert und in dessen Datenwelt übersetzt wird. Ein Wechsel des Werkzeugs nimmt uns diese Arbeit nicht ab.
Sechs Kontextebenen für bessere Antworten
OpenAI beschreibt in einem Erfahrungsbericht, wie sich technische Informationen, fachliches Wissen und Rückmeldungen aus der Nutzung zu einem KI-gerechten Kontext zusammenführen lassen. Spannend ist aus meiner Sicht vor allem die systematische Unterteilung in sechs aufeinander aufbauenden Kontextebenen, die mal mehr, mal weniger Aufwand erfordern.
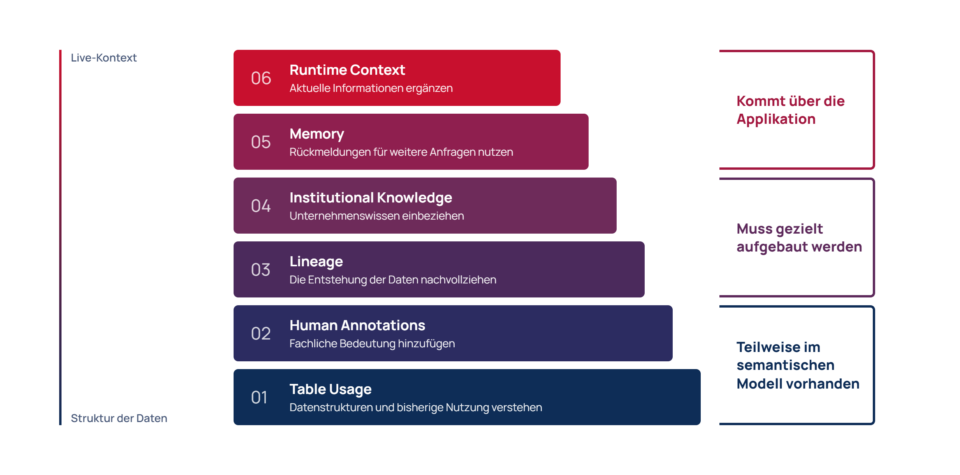
Diese Differenzierung bietet auch für andere Data-Agent-Projekte eine hilfreiche Orientierung:
- Table Usage: Datenstrukturen und bisherige Nutzung verstehen
Die erste Ebene beschreibt die technische Struktur der Daten. Dazu gehören Datenbankschemata, Informationen über Herkunft und Verarbeitung der Daten sowie historische SQL-Abfragen. Teilweise ist dieses Wissen schon im semantischen Modell vorhanden. Es hilft dem Agenten, relevante Tabellen zu identifizieren und zu erkennen, wie sich diese sinnvoll miteinander verknüpfen lassen. - Human Annotations: Fachliche Bedeutung hinzufügen
Technische Strukturen allein erklären noch nicht, was Daten für das Geschäft bedeuten. Dafür braucht es fachliche Beschreibungen, eindeutige Kennzahlendefinitionen und Hinweise von Experten. Diese Informationen ermöglichen es dem Agenten, Unternehmensbegriffe richtig zu interpretieren, statt sich allein an Tabellen- oder Spaltennamen zu orientieren. Auch sie werden mitunter schon vom semantischen Modell geliefert. - Lineage: Die Entstehung der Daten nachvollziehen
Hier beginnt die Arbeit so richtig. Es gilt den Code einzufügen, mit dem Daten aufbereitet werden. Die Analyse von ETL-, Python- und SQL-Code erschließt daraufhin Berechnungslogiken und Filter. Infolgedessen erhält der Agent ein genaueres Bild davon, wie die Daten entstanden sind und welche Verarbeitungsschritte bereits in ihnen stecken. - Institutional Knowledge: Unternehmenswissen einbeziehen
Nicht jedes relevante Detail steht in einer Datenbank. Dokumentationen, Wikis und interne Kommunikationskanäle enthalten Wissen über Projekte, Prozesse und unternehmensspezifische Begriffe. Auch diesen organisatorischen Kontext benötigt der Agent, um Fragen und Ergebnisse fachlich einordnen zu können. Wie die Lineage muss er gezielt aufgebaut werden. - Memory: Rückmeldungen für weitere Anfragen nutzen
Korrekturen und Präferenzen aus der Nutzung sollen nicht mit dem Ende einer Unterhaltung verloren gehen. Eine in der Applikation integrierte Memory-Funktion speichert solche Informationen für spätere Anfragen. Dabei kann es sowohl um persönliche Präferenzen als auch um Wissen gehen, das über einzelne Nutzer hinaus relevant ist. - Runtime Context: Aktuelle Informationen ergänzen
Schließlich braucht der Agent die Möglichkeit, seinem hinterlegten Kontext aktuelles Wissen hinzuzufügen. Live-Zugriffe auf Datenbanken und Metadatendienste liefern Informationen, die zum Zeitpunkt der Abfrage relevant sind. Der Agent arbeitet damit nicht ausschließlich auf Grundlage des zuvor zusammengestellten Wissens. Generell ist eine solche Funktion ebenfalls schon Bestandteil der Applikation.
Die sechs Ebenen machen deutlich: Kontext entsteht nicht durch eine einzelne Beschreibung, die wir dem Agenten zum Start mitgeben. Er setzt sich aus technischen Strukturen, fachlichen Definitionen, Verarbeitungslogiken, Unternehmenswissen und Rückmeldungen zusammen.
Viele Unternehmen verfügen bereits über ausgereifte semantische Modelle, die den erforderlichen Kontext für die ersten beiden Ebenen liefern. In diesen Fällen funktionieren funktionieren Out-of-the-box-Agenten teils erstaunliche Gut. Grundsätzlich lässt sich aber als Konsequenz für Agent-Projekte ableiten, dass wir das Erschließen dieses Wissens nicht als unbequeme Vorleistung betrachten sollten, die möglichst schnell erledigt werden muss. Es gehört zur eigentlichen Entwicklung der Lösung.
Gedankenspiele zu herstellerunabhängigen Data Agents
Neben der Kontextfrage beschäftigt mich die Architektur von Agenten-Lösungen. Für den Analytics-Bereich finde ich die Vorstellung eines eigenständigen Dienstes attraktiv, der über einzelne Datenbanken und Data Lakes hinweg arbeiten kann – unabhängig davon, ob dahinter beispielsweise Databricks, Microsoft Fabric oder Snowflake steht. Denn: Ein solcher Agent wäre nicht von vornherein auf die Grenzen einer einzelnen Plattform festgelegt.
Diese Überlegung reicht über den Agenten selbst hinaus. Auch bei Data Contracts, Ontologien und semantischen Modellen stellt sich die strategische Frage, wie eng ein Unternehmen zentrale Bestandteile seiner Datenstrategie an proprietäre Werkzeuge binden möchte. Aus meiner Sicht spricht vieles dafür, Herstellerunabhängigkeit bei diesen Entscheidungen zumindest mitzudenken.
Das ist allerdings kein pauschales Argument gegen native Plattformwerkzeuge. Ich würde hier zwischen Analytics und klassischen Entwicklungsaufgaben unterscheiden. Bei der Entwicklung erwarte ich, dass native Werkzeuge durch ihre tiefe Integration häufig im Vorteil bleiben, wie etwa. Genie Code in Databricks. Bei plattformübergreifenden Analysen sehe ich dagegen ein interessantes Potenzial in unabhängigen Lösungen.

Fazit: Der Nutzen beginnt beim Unternehmenswissen
Ich gehe davon aus, dass Data Agents im Analytics-Umfeld weiter an Bedeutung gewinnen werden. Wie weit sich die Vision eines durchgängig plattformübergreifenden Agenten technisch umsetzen lässt, bleibt dabei eine offene Frage.
Meine wichtigste Schlussfolgerung aus der Projektarbeit ist jedoch klar: Die Qualität eines Data Agents lässt sich nicht auf die Wahl des Modells, der Applikation oder der Plattform reduzieren. Unternehmen sollten sich darauf vorbereiten, Kontext, Tool, Plattform und Agenten unabhängig aufzubereiten und bereitzustellen. Denn: Wer gute Antworten erwartet, muss nicht nur in den Datenzugriff investieren, sondern vor allem in den Kontext.
ORAYLIS hilft Unternehmen, individuelle KI-Agenten für unterschiedlichste Aufgaben zu entwickeln. Dabei legen wir Wert auf ein stabiles Fundament, das das die produktive Nutzung und eine schnelle Skalierbarkeit in den Mittelpunkt stellt. Kontaktieren Sie uns gerne.
→ Wir realisieren Ihre KI-Lösung
Zum Autor
Lukas Lötters
Principal Consultant – Data Science
Lukas Lötters ist bei ORAYLIS Leiter des Kompetenzteams AI & Data Science. Seit 2015 begleitet er Unternehmen ganzheitlich auf ihrem Weg zur produktiven KI – von der Strategie über die Identifikation geeigneter Use Cases bis hin zur Umsetzung in Microsoft Azure und Databricks. Seine Kernexpertise liegt in der Konzeption und dem Aufbau von Machine-Learning-, Generative-AI- und Agenten-Lösungen mit besonderem Branchenfokus auf den Handel und der Bedarfsprognose. Als Speaker teilt er auf Konferenzen und in Webinaren sein Praxiswissen zu KI-Themen aktiv mit der Fachcommunity.