Was macht ein Data Engineer?
Ein Data Engineer entwickelt und betreibt die technischen Prozesse, mit denen Daten gesammelt, gespeichert, verarbeitet und bereitgestellt werden. Im Mittelpunkt steht der Aufbau einer zuverlässigen und skalierbaren Dateninfrastruktur.
Zu den wichtigsten Aufgaben eines Data Engineers gehören:
- Datenintegration: Daten aus unterschiedlichen Quellen wie ERP-Systemen, CRM-Anwendungen, Datenbanken oder Maschinen zusammenführen.
- Entwicklung von Datenpipelines: Automatisierte Prozesse aufbauen, die Daten zwischen Systemen übertragen und verarbeiten.
- Datenaufbereitung: Rohdaten bereinigen, transformieren, vereinheitlichen und für verschiedene Anwendungsfälle nutzbar machen.
- Datenmodellierung: Datenstrukturen entwickeln, die effiziente Abfragen und Analysen ermöglichen.
- Sicherstellung der Datenqualität: Datenflüsse überwachen, Fehler erkennen und die Zuverlässigkeit der bereitgestellten Daten sicherstellen.
- Aufbau und Betrieb von Datenplattformen: Technologien wie Data Warehouses, Data Lakes oder Data Lakehouses implementieren und weiterentwickeln.
- Datensicherheit und Governance: Technische Maßnahmen für Zugriffsschutz, Nachvollziehbarkeit und die Einhaltung definierter Datenrichtlinien umsetzen.
Im modernen Cloud-Kontext bedeutet das: Der Data Engineer entwickelt für Unternehmen unter Einsatz entsprechender Tools Transformationsprozesse, die strukturierte und unstrukturierte Daten – größtenteils automatisiert – speichern, analysieren und für die Datenvisualisierung bereitstellen. Gleiches gilt für die laufende Qualitätssicherung im Lösungsbetrieb.
Darüber hinaus unterstützt der Data Engineer mit seinem Know-how beim Aufbau von Datenmodellen und Lösungsarchitekturen. Ebenso übernimmt er eine beratende Funktion gegenüber fachfremden Personen aus anderen Abteilungen.
Ein Data Engineer arbeitet dabei eng mit Data Analysts, Data Scientists, IT-Teams und den Fachabteilungen zusammen.
Wie arbeitet ein Data Engineer? Ein Praxisbeispiel
In einem Industrieunternehmen entstehen täglich große Datenmengen: Produktionsanlagen liefern Maschinendaten, das ERP-System enthält Bestellungen und Materialbestände, während weitere Anwendungen Informationen über Lieferzeiten und Qualität bereitstellen.
Diese Daten liegen häufig in unterschiedlichen Systemen und Formaten vor. Eine gemeinsame Auswertung ist deshalb nur mit erheblichem manuellem Aufwand möglich.
Hier setzt der Data Engineer an:
- Datenquellen anbinden: Er verbindet die verschiedenen Systeme mit einer zentralen Datenplattform.
- Daten automatisiert übertragen: Datenpipelines übernehmen die regelmäßige Übertragung der benötigten Informationen.
- Daten transformieren: Unterschiedliche Formate werden vereinheitlicht, fehlerhafte Datensätze erkannt und relevante Informationen miteinander verknüpft.
- Daten bereitstellen: Die aufbereiteten Daten stehen beispielsweise in einem Data Warehouse oder Data Lakehouse für weitere Anwendungen zur Verfügung.
- Prozesse überwachen: Der Data Engineer kontrolliert die Datenflüsse und stellt sicher, dass Fehler frühzeitig erkannt und behoben werden.
Auf dieser Grundlage können Unternehmen beispielsweise Produktionskennzahlen in Power BI analysieren, Lieferengpässe frühzeitig erkennen oder KI-Modelle zur vorausschauenden Wartung entwickeln.
Der Mehrwert: Daten müssen nicht für jede Auswertung erneut manuell zusammengetragen werden. Stattdessen entsteht eine wiederverwendbare und zuverlässige Datengrundlage.
Welche Technologien und Tools nutzt ein Data Engineer?
Data Engineers arbeiten mit verschiedenen Programmiersprachen, Datenbanken und Plattformtechnologien. Welche Tools zum Einsatz kommen, hängt von der vorhandenen IT-Landschaft und den Anforderungen des Unternehmens ab.
Programmiersprachen und Datenverarbeitung
- SQL: Zum Abfragen, Verknüpfen und Transformieren von Daten in relationalen Datenbanken und analytischen Systemen.
- Python: Zur Automatisierung von Datenprozessen, Entwicklung von Pipelines und Verarbeitung von Daten.
- Apache Spark und PySpark: Zur verteilten Verarbeitung großer Datenmengen.
- Scala: Eine weitere Programmiersprache, die unter anderem im Umfeld von Apache Spark eingesetzt wird.
Cloud- und Datenplattformen
Moderne Data-Engineering-Projekte werden häufig auf Cloud-Plattformen umgesetzt. Dazu zählen beispielsweise:
- Microsoft Azure: Cloud-Dienste für die Speicherung, Integration und Verarbeitung von Daten.
- Microsoft Fabric: Eine integrierte Analyseplattform mit Funktionen für Datenintegration, Data Engineering, Data Warehousing und Analytics.
- Azure Databricks: Eine Plattform für skalierbare Datenverarbeitung, Data Engineering und Machine Learning.
- Data Warehouses und Data Lakehouses: Architekturen zur zentralen Speicherung und Bereitstellung von Daten für unterschiedliche Analyseanforderungen.
Datenpipelines und Automatisierung
Eine zentrale Aufgabe im Data Engineering ist die Entwicklung von ETL- und ELT-Prozessen.
Bei ETL (Extract, Transform, Load) werden Daten aus Quellsystemen extrahiert, transformiert und anschließend in ein Zielsystem geladen. Bei ELT (Extract, Load, Transform) werden die Daten zunächst in das Zielsystem geladen und dort weiterverarbeitet.
Beide Verfahren ermöglichen automatisierte Datenflüsse. Welche Variante sinnvoll ist, hängt unter anderem von der Datenarchitektur, den Datenquellen und den Verarbeitungsanforderungen ab.
Welche Fähigkeiten braucht ein Data Engineer?
Ein Data Engineer benötigt umfangreiche Kenntnisse im Bereich der Datenverarbeitung. Diese lassen sich primär in der Praxis erwerben. Ein Studium beispielsweise der Wirtschaftsinformatik oder einer Ausbildung zum Fachinformatiker können hierbei für die notwendigen Grundlagen sorgen.
Hinzu kommen fortgeschrittene Kompetenzen in verschiedenen Programmiersprachen, wie Python oder Scala sowie Erfahrungen mit relationalen Datenbanken bzw. Abfragesprachen, wie SQL. Kenntnisse bei der Anwendung von moderner Cloud Technologie sind ebenfalls hilfreich.
Neben den technischen Aspekten spielen im Job des Data Engineers aber auch Soft Skills eine zunehmend große Rolle. Bei der Entwicklung moderner Datenlösungen ist eine gute Kommunikation zwischen unterschiedlichen Interessensgruppen entscheidend für den Erfolg. Daher sollte ein Data Engineer auch auf Menschen eingehen und komplexe technische Sachverhalte verständlich darstellen können.
Was ist der Unterschied zwischen Data Engineer, Data Analyst und Data Scientist?
Data Engineers, Data Analysts und Data Scientists arbeiten häufig mit denselben Daten, übernehmen aber unterschiedliche Aufgaben.
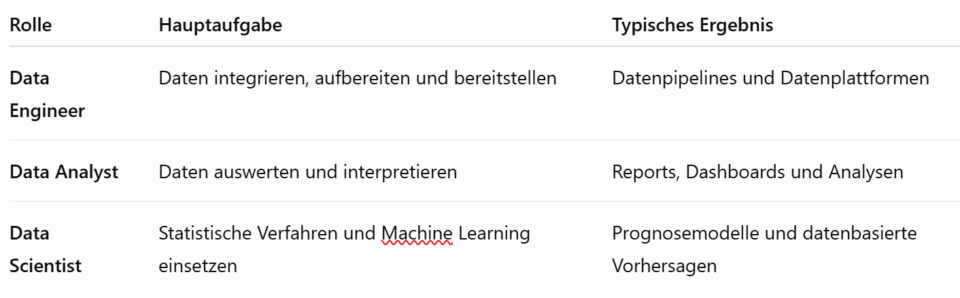
Ein Data Engineer schafft somit häufig die technische Voraussetzung für die Arbeit von Data Analysts und Data Scientists.
Beispiel: Während der Data Engineer Produktionsdaten aus verschiedenen Systemen automatisiert zusammenführt, analysiert ein Data Analyst die Entwicklung der Produktionskennzahlen. Ein Data Scientist kann diese Daten anschließend nutzen, um ein Modell zur Vorhersage von Maschinenausfällen zu entwickeln.
In der Praxis können sich die Verantwortlichkeiten überschneiden. Insbesondere in kleineren Teams übernehmen einzelne Fachkräfte mehrere Aufgabenbereiche.
Welche Rolle spielt Data Engineering für KI?
Data Engineering ist eine wichtige Voraussetzung für den erfolgreichen Einsatz Künstlicher Intelligenz im Unternehmen. KI-Anwendungen benötigen geeignete, zugängliche und möglichst zuverlässige Daten. Liegen Informationen in getrennten Systemen, unterschiedlichen Formaten oder unzureichender Qualität vor, erschwert dies die Entwicklung und den produktiven Einsatz von KI-Lösungen. Data Engineers schaffen die technischen Voraussetzungen, indem sie Datenquellen integrieren, Datenpipelines automatisieren und Daten für KI-Anwendungen bereitstellen.
Das gilt beispielsweise für:
- Predictive Maintenance: Maschinendaten werden aufbereitet, damit KI-Modelle mögliche Ausfälle vorhersagen können.
- Absatzprognosen: Historische Verkaufs-, Bestands- und Marktdaten werden für Prognosemodelle zusammengeführt.
- KI-Agenten: Relevante Unternehmensdaten werden über geeignete Schnittstellen und Datenprozesse für KI-gestützte Anwendungen verfügbar gemacht.
Data Engineering allein garantiert allerdings noch keine verlässlichen KI-Ergebnisse. Zusätzlich sind unter anderem geeignete Modelle, klare Zuständigkeiten, Zugriffskontrollen und eine kontinuierliche Qualitätsprüfung erforderlich.
Warum ist Data Engineering für Unternehmen wichtig?
Unternehmen verfügen häufig über große Datenbestände, können diese aber nicht durchgängig nutzen. Unterschiedliche Systeme, manuelle Datenübertragungen und fehlende Standards erschweren eine konsistente Auswertung. Professionelles Data Engineering hilft, diese Herausforderungen zu bewältigen.
Die wichtigsten Vorteile sind:
- Höhere Datenqualität: Einheitliche Prüf- und Transformationsprozesse verbessern die Verlässlichkeit der Daten.
- Weniger manueller Aufwand: Automatisierte Datenpipelines reduzieren wiederkehrende Tätigkeiten.
- Aktuellere Informationen: Regelmäßige oder ereignisgesteuerte Datenverarbeitung ermöglicht eine zeitnahe Bereitstellung.
- Skalierbarkeit: Datenplattformen können an steigende Datenmengen und zusätzliche Anwendungsfälle angepasst werden.
- Bessere Entscheidungsgrundlagen: Fachabteilungen greifen auf konsistente und nachvollziehbare Informationen zu.
- Grundlage für KI: Aufbereitete und zugängliche Daten erleichtern die Entwicklung datenbasierter und KI-gestützter Anwendungen.
Damit ist Data Engineering ein wesentlicher Bestandteil einer modernen Datenstrategie und einer leistungsfähigen Data & AI Platform.
Der Data Engineering als Berufsbild der Zukunft? Hier geht´s zu unserer Stellenausschreibung:


